Retrieval Augmented Generation
RAG.
Wissen.
Präzision.
RAG-Systeme verbinden KI-Sprachmodelle mit Ihrer Wissensdatenbank: präzise Antworten auf Basis Ihrer eigenen Dokumente, Verträge und Daten — keine Halluzinationen, keine unkontrollierte Datenweitergabe.
RAG-Projekt anfragen →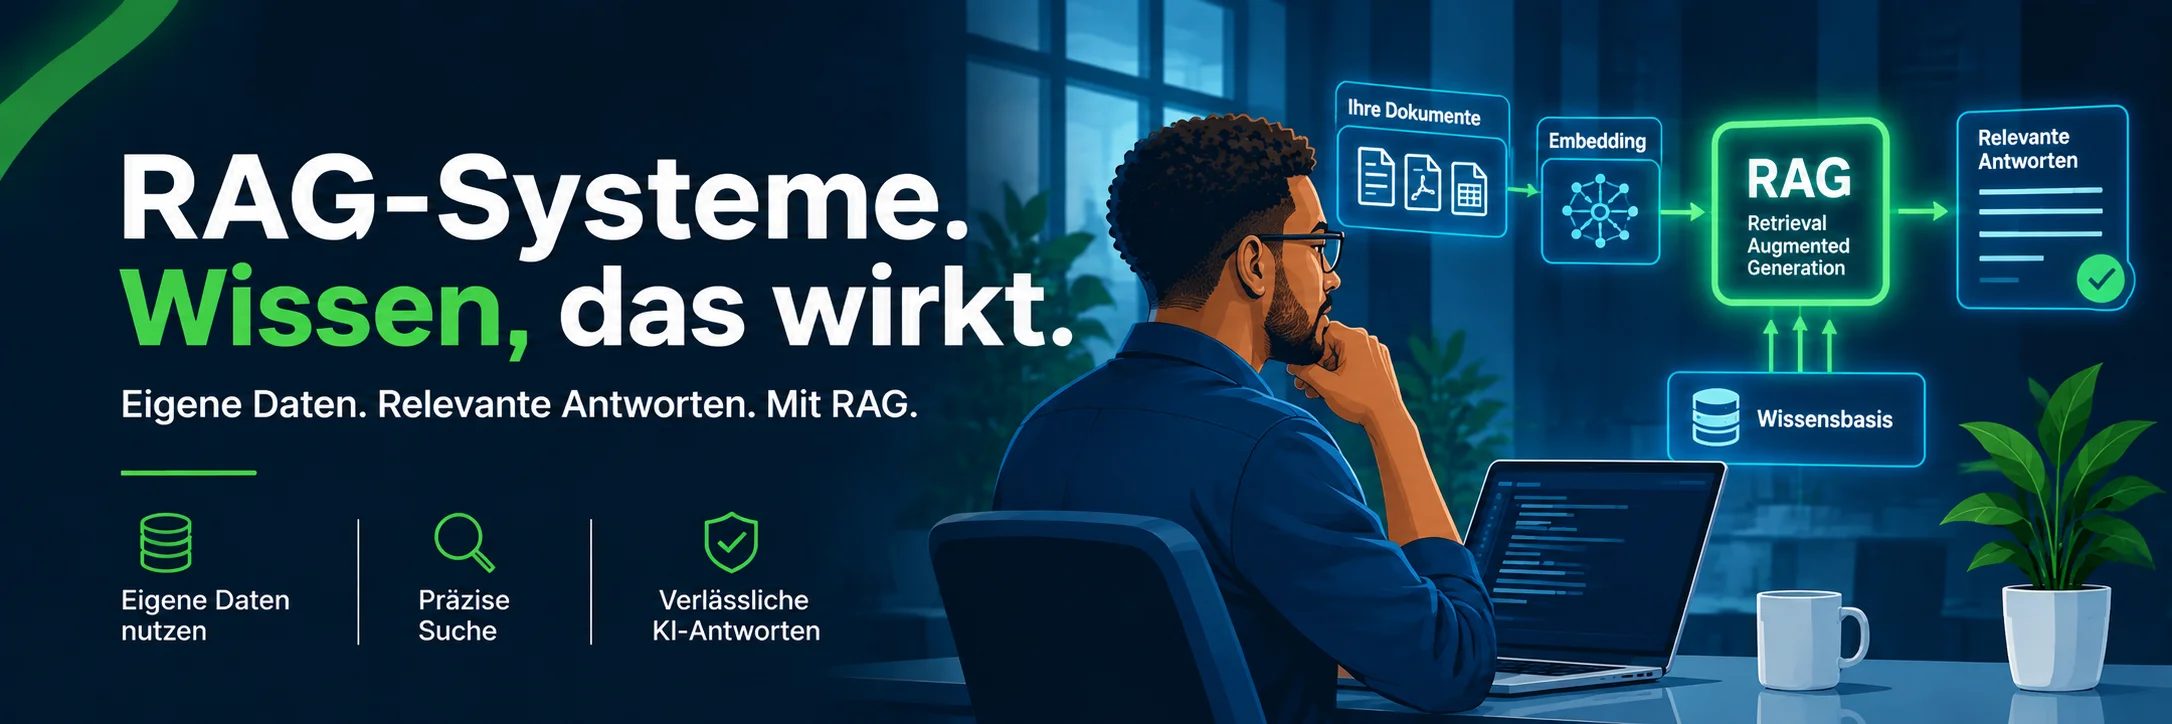
Was ist ein RAG-System und warum brauchen Unternehmen es?
Standard-KI-Modelle wie ChatGPT oder Claude kennen Ihr Unternehmen nicht. Sie wissen nichts über Ihre internen Prozesse, Verträge, Produkthandbücher oder Kundendaten. RAG-Systeme lösen dieses Problem: Sie verknüpfen das Sprachverständnis eines KI-Modells mit dem spezifischen Wissen Ihrer Organisation.
Technisch funktioniert RAG in zwei Schritten: Zuerst werden alle relevanten Dokumente in eine Vektordatenbank (Pinecone, Chroma, pgvector) eingelesen und als semantische Repräsentationen gespeichert. Bei einer Anfrage sucht das System die passendsten Textfragmente heraus und gibt sie dem Sprachmodell als Kontext mit. Die KI antwortet dann auf Basis Ihrer echten Daten — mit Quellenangaben, überprüfbar und nachvollziehbar.
Typische Anwendungsfälle: interner Wissens-Chatbot (Mitarbeiter fragen Handbücher, Richtlinien, Verträge ab), Kundensupport-Bot (beantwortet Fragen auf Basis von FAQs und Produktdokumentation), Legal-Q&A-System (Anwälte durchsuchen Vertragsarchive per natürlicher Sprache), Due-Diligence-Assistent für Makler oder Berater.
RAG-System Entwicklung: Wie eyedia vorgeht
eyedia entwickelt RAG-Systeme von der Datenpipeline bis zum fertigen Interface. Schritt 1 ist die Datenaufnahme: Welche Quellen soll das System kennen — PDFs, Datenbanken, SharePoint, Notion, E-Mails? Wir bauen Ingestion-Pipelines, die Daten strukturiert einlesen, bereinigen und in die Vektordatenbank überführen.
Schritt 2 ist das Retrieval: Welche Chunks (Textfragmente) werden bei welcher Anfrage zurückgegeben? Die Qualität des Retrievals entscheidet über die Präzision der Antworten. Wir optimieren Chunk-Größen, Embedding-Modelle und Retrieval-Strategien für Ihren spezifischen Datentyp.
Für datensensible Branchen — Gesundheit, Recht, Finanzen — setzen wir das gesamte System auf Ihrer eigenen Infrastruktur auf: Self-Hosted-Modelle mit Ollama, eigene Vektordatenbank, kein externer Datenabfluss. Vollständig DSGVO-konform.
Tech-Stack
Häufige Fragen
Was ist ein RAG-System?↓
RAG steht für Retrieval Augmented Generation. Ein RAG-System kombiniert ein KI-Sprachmodell mit einer Wissensdatenbank: Wenn eine Frage gestellt wird, sucht das System zuerst relevante Dokumente aus der Datenbank und nutzt diese als Kontext für die KI-Antwort. So bekommt man präzise, quellenbasierte Antworten statt allgemeine KI-Halluzinationen.
Welche Datenquellen kann ein RAG-System verarbeiten?↓
PDFs, Word-Dokumente, Excel-Dateien, Webseiten, Datenbankeinträge, E-Mails, Confluence, Notion, SharePoint und eigene APIs. eyedia entwickelt die passenden Daten-Pipelines für jede Quelle.
Verlassen meine Daten das Unternehmen?↓
Nicht zwingend. Für datensensible Branchen setzen wir RAG-Systeme mit Self-Hosted-Modellen (Llama, Mistral via Ollama) auf Ihrer eigenen Infrastruktur auf. Kein Cloud-Anbieter erhält Zugriff auf Ihre Daten.
Wie lange dauert die Entwicklung eines RAG-Systems?↓
Ein RAG-MVP mit einer Datenquelle und einfachem Chat-Interface ist in 3–4 Wochen produktiv. Produktionssysteme mit mehreren Quellen, Zugriffssteuerung und Monitoring dauern 6–10 Wochen.
Ergänzend dazu